


Содержание статьи
Полезные материалы
17.10.2026
17.10.2026
9
мин
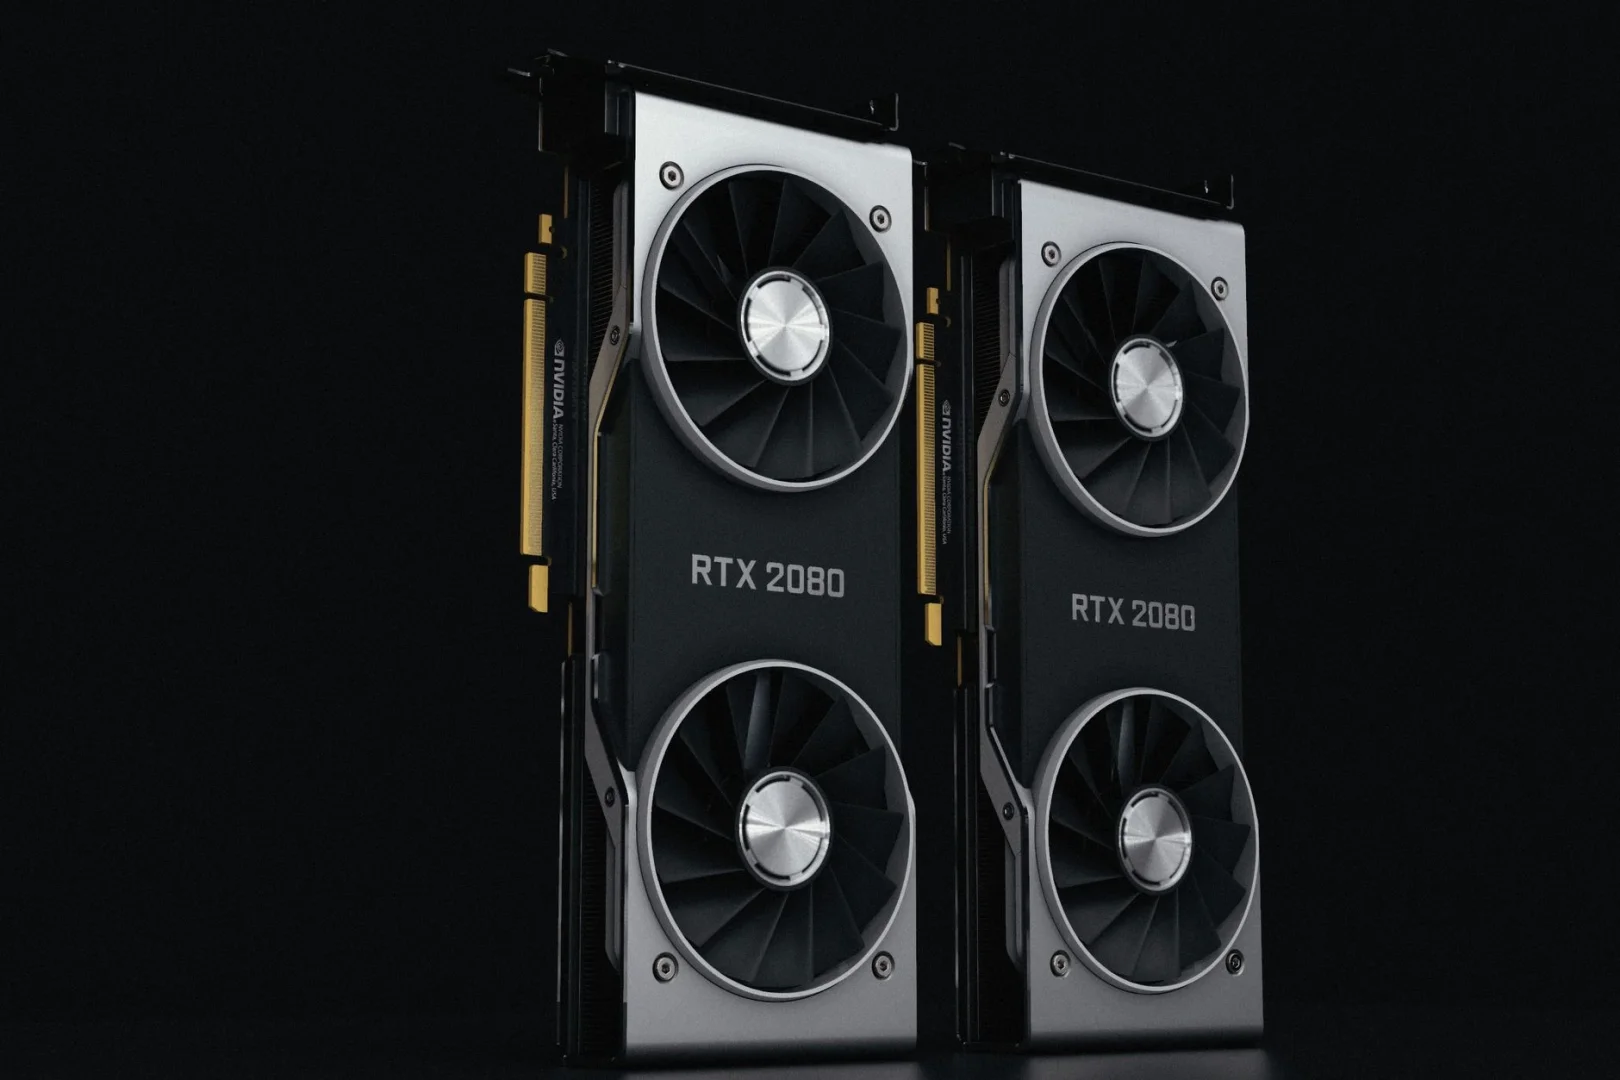
Две видеокарты по 20 ГБ на первый взгляд похожи на одну карту с 40 ГБ памяти. Но память не превращается в общий резервуар: модель и её вычисления приходится распределять между устройствами, а объём памяти сам по себе не определяет скорость ответа. Это видно в инженерном кейсе Александра Щербакова, DevOps-инженера X5 Tech. В его тестах вторая CMP 50HX помогала разместить более крупную модель и увеличить длину контекста, но почти не ускоряла короткую генерацию.
Отчёт опубликован на Хабре; точная дата в доступном тексте не указана. В нём упоминается сентябрь 2026 года. Это описание одного стенда и авторских замеров, а не рецензируемая научная работа. Полный текст доступен в отчёте Александра Щербакова. Отдельный проект xrip на GitHub описывает разблокировку и аппаратные проверки CMP, но не является независимым подтверждением приведённых в статье скоростей языковых моделей.
Что именно испытывали
Щербаков испытывал не штатные CMP 50HX. Карты переделали: объём видеопамяти увеличили с 10 до 20 ГБ, расширили интерфейс PCIe, а вычислительные ограничения снимали с помощью изменённого драйвера. Сервер собран на материнской плате TYAN S8030GM2NE с процессором AMD EPYC 7K62 и 128 ГБ оперативной памяти. Контрольные тесты проходили в виртуальной машине с 8 виртуальными процессорными ядрами и 16 ГиБ оперативной памяти. В ранних замерах машине выделили 16 ядер и 32 ГиБ. Автор отдельно предупреждает: результаты этих серий нельзя считать полученными в одинаковых условиях.
Модели запускали в BeeLlama.cpp, изменённой версии программного движка llama.cpp. Щербаков сравнивал одну и две видеокарты, несколько моделей Qwen и Ornith, разные уровни квантования, размеры контекста и режим, в котором система предварительно прогнозирует следующие токены. Дополнительный модуль предлагает продолжение, а основная модель его проверяет. Если прогноз часто оказывается верным, за один шаг удаётся выдать больше токенов. Если проверка занимает слишком много времени, выигрыш сокращается.
В замерах отдельно учитывались обработка входа и генерация ответа. Предварительная обработка загружает входной текст, а декодирование создаёт новые токены. В нескольких сериях контекст заполняли повторяющимся токеном, а не содержательным документом. Поэтому эти результаты показывают, как меняется скорость при увеличении кэша контекста, но не измеряют работу с настоящим текстом и не говорят о качестве ответа.
Вторая карта расширяет вместимость
Показательно сравнение Qwen3.6-35B-A3B с квантованием IQ4_NL. В коротком тесте с предварительным прогнозированием одна карта выдала 120,32 токена в секунду, две вместе 118,01. В этой серии вторая карта не ускорила генерацию.
Зато распределение модели между двумя устройствами позволило увеличить контекст. На одной карте Щербаков дошёл до 192 000 токенов, оставив всего 715 МиБ свободной видеопамяти. На двух картах он проверил контекст длиной 260 000 токенов. Память устройств не складывается автоматически в единый непрерывный пул: модель и кэш распределяют между картами. Если на одной из них не хватает памяти, это станет ограничением, даже когда на другой ещё есть запас.
Похожее наблюдение есть в более ранних пользовательских тестах CMP. В 2025 году WebSlave тоже описывал две карты прежде всего как способ увеличить доступную память, а не гарантированно ускорить один ответ. Напрямую сопоставлять эти результаты нельзя: конфигурации и программные среды различались. Осторожности требует и выбор вычислительной библиотеки: в другом материале WebSlave отмечал, что одна и та же CMP может работать по-разному в разных программных движках.
Длинный контекст замедляет генерацию
В тесте Qwen3.8-27B с квантованием IQ4_NL скорость декодирования на одной CMP 50HX снизилась с 26,47 токена в секунду при контексте в 4 096 токенов до 12,14 при 131 072 токенах. Включение предварительного прогнозирования в этой же серии подняло скорость на максимальной длине контекста до 20,21 токена в секунду. Результат относится к конкретной модели, сборке и синтетическому заполнению контекста. Он не обещает такой же прибавки на любом запросе.
В серии с Qwen3.6 на двух картах относительная прибавка от предварительного прогнозирования росла вместе с контекстом: с 38,7% при 32 768 токенах до 86,6% при 260 000. Это не значит, что длинный запрос обрабатывался быстрее короткого: с увеличением контекста сама скорость генерации снижалась. Проценты сравнивают два режима при одинаковой длине контекста.
Глубина прогноза тоже не даёт постоянного выигрыша. В тесте Ornith-1.5-35B-A3B с контекстом около 260 000 токенов глубина 3 дала 64,46 токена в секунду, а глубина 2 дала 53,42. Но на входе длиной 4 096 токенов глубина 3 показала худший результат: 117,54 против 138,27. Настройка зависит от длины и условий теста. Правило «чем больше прогнозов, тем быстрее» здесь не работает.
Что позволяют заключить эти замеры
По выводу автора, модифицированные CMP 50HX подошли для его домашнего сервера локальных языковых моделей. На одной карте помещалась Qwen3.6 с квантованием IQ4_NL, а две карты позволяли работать с более длинным контекстом и более тяжёлым квантованием. Наш вывод уже: этот кейс показывает, как объём видеопамяти и настройки генерации влияют на измеренную скорость, но не устанавливает универсальную производительность CMP 50HX.
У результатов есть существенные ограничения. Карты переделали, драйвер изменили, а ранние и контрольные тесты проводили в виртуальных машинах с разными ресурсами. Для части результатов приведён один ответ; для Ornith указаны три повтора, чего мало для надёжной оценки разброса. В сравнении Q6_K на одной и двух картах менялось не только число графических процессоров: на одной часть модели считалась с использованием системной памяти, а на двух модель целиком размещалась в видеопамяти. Наконец, повторяющийся синтетический токен ничего не говорит о качестве кода или ответа.
Автор приводит команды и конфигурации в GitLab, но файлы BENCHMARKS.md, описания тестов и конфигураций в доступных материалах не открылись. Полностью повторить расчёты по представленным источникам поэтому нельзя. Автор также прямо указывает, что не запускал в тех же тестах RTX 2080 Ti, с которой сравнивает характеристики CMP. Для оценки того, насколько бенчмарк действительно измеряет интересующее свойство, полезно различать сам показатель и его валидность, как объясняет разбор того, что на самом деле измеряют бенчмарки ИИ.
Отчёт не доказывает, что две недорогие карты заменят одну мощную. Они могут дать больше доступной видеопамяти и позволить разместить модель или контекст, которым не хватает места на одной карте. Ускорение зависит от модели, программной сборки, распределения вычислений и режима генерации. Его нужно проверять на собственной нагрузке.
Источники
- Александр Щербаков. «Собираем домашний сервер для локальных LLM на доступных GPU (NVIDIA CMP 50HX)». Хабр, дата публикации в доступном тексте не указана. Полный текст.
- xrip. cmp50hx-unlock: проект разблокировки CMP 50HX и описания аппаратных проверок. Дата материалов не установлена. Репозиторий GitHub.
- WebSlave. «Темные лошадки ИИ: инференс LLM на майнинговых видеокартах Nvidia CMP 40HX, CMP 50HX, CMP 90HX». Хабр, 24 августа 2025 года. Полный текст.
- WebSlave. «NVIDIA CMP: микроскопы для забивания гвоздей? Копаем глубже…». Хабр, 18 сентября 2025 года. Полный текст.
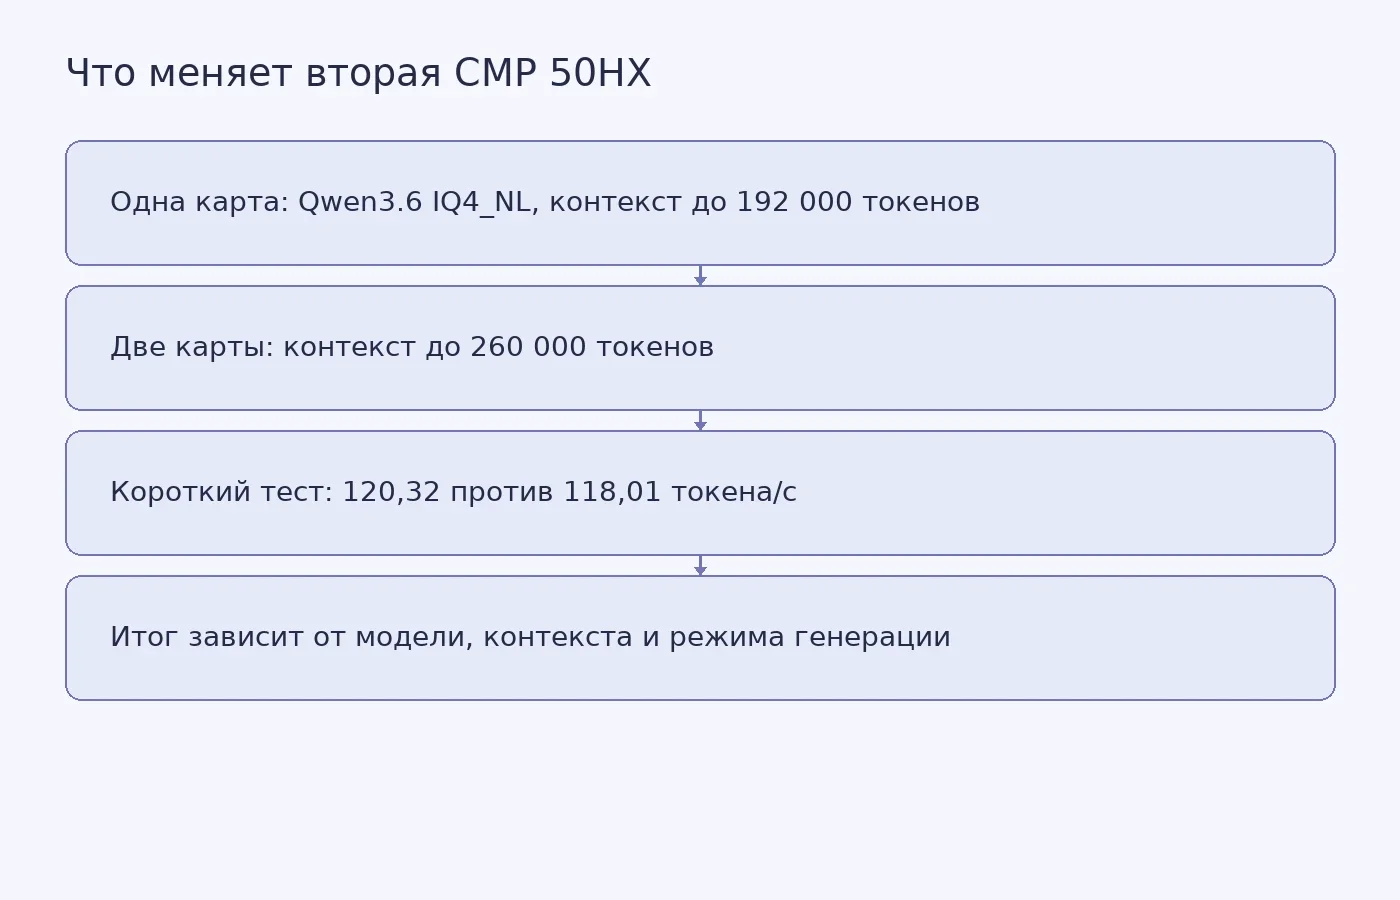
Фото: Nana Dua / Pexels


Похожие статьи
 Полезные материалы
11
мин
05.10.2026
Почему диаризация на потоке оказалась быстрее пакетной: разбор Nemotron 3 Diarization
Двое говорят одновременно — и старая схема разметки голосов ломается. Не потому, что она плохо написана, а потому, что устроена иначе: она режет запись на куски, снимает с каждого отпечаток голоса и складывает похожие отпечатки в кучки. Если в куске звучат два человека, отпечаток получается смешанны
 Полезные материалы
15
мин
26.02.2026
1
Как провести летние каникулы с пользой
Как провести летние каникулы с пользой Кроме полноценного отдыха, летние каникулы можно использовать для закрепления знаний по специальности, а также развития дополнительных навыков, которые помогут трудоустроиться на престижную вакансию. Предлагаем ознакомиться с популчрными видами стажировок, т
 Полезные материалы
25
мин
11.10.2026
Синтез речи на длинной дистанции: что ломается при чтении целого романа
Четырнадцать фраз, нарочно набитых самыми трудными звуками крымскотатарского — къ, гъ, нъ, дж, — выглядят как честный экзамен для синтезатора речи. На них удобно сравнивать версии модели между собой. Но между этим экзаменом и чтением романа вслух лежит пропасть, и автор проекта «Ана юрт» показал её
 Полезные материалы
13
мин
04.03.2026
1
Экологичный подход к учебе: как учёба может быть zero-waste
Чтобы сохранить энергию и снизить перегрузку, необходимо грамотно подойти к распределению времени, сконцентрировавшись на важных моментах, приносящих результат. Экологичный подход к учебе поможет эффективнее относиться к собственным и внешним ресурсам, акцентируясь на практической ценности затраченн
 Полезные материалы
8
мин
07.10.2026
Ночная очистка мозга: что сон и глимфатическая система могут рассказать о болезни Альцгеймера
Мозг не выключается, когда человек засыпает. Среди процессов, которые меняются во время сна, учёные изучают движение жидкости вокруг сосудов и перенос растворённых веществ в мозговой ткани. Эту предполагаемую сеть путей называют глимфатической системой: название отсылает к глиальным клеткам и лимфат
 Полезные материалы
15
мин
03.10.2026
Почему подбор кодов помещений упирается в разногласия проектов, а не в метрику сходства строк
В жилом доме сотни помещений, и в модели они называются так, как привыкла мастерская: «С/у», «Кладовка», «ПУИ/Мусороудаление (К1)», «Элетрощитовая жилой части». С 2026 года архитектурно-градостроительное решение в Москве сдаётся вместе с цифровой информационной моделью в IFC, и у каждого помещения д
Последние новости и статьи
 Наука
2
мин
17.10.2026
ИИ-система собрала данные о свойствах продуктов и выявила общую закономерность
16 октября 2026 года исследователи Университета штата Пенсильвания сообщили, что система AgentXtract собрала более 4 000 экспериментальных записей о пищевых продуктах за полчаса. Анализ этой базы показал связь между двумя свойствами более чем 100 продуктов. Результаты опубликовали онлайн в журнале J
 Наука
3
мин
17.10.2026
Переменный конденсатор помог различить заряды в двумерных квантовых точках
Исследователи из Университета Тохоку и Национального института материаловедения Японии настроили радиочастотную измерительную схему, чтобы различать изменения заряда в высокоомных квантовых точках. В статье, опубликованной 20 августа 2026 года в журнале npj 2D Materials and Applications, они описали
 Образование
2
мин
17.10.2026
СПбГУТ и «Алгоритмика» объявили набор школьников на ИТ-курсы
16 октября 2026 года Санкт-Петербургский государственный университет телекоммуникаций имени Бонч-Бруевича сообщил о наборе учеников 6–11-х классов на курсы Цифровой академии школьников, которые университет проводит вместе со школой «Алгоритмика». Группы будут начинать занятия по мере набора, но точн
 Полезные материалы
9
мин
17.10.2026
Как понять, что ученик действительно разобрался в теме
В классе тихо: ученики смотрят видео, просматривают конспекты, кивают во время объяснения. Но по этой картине не понять, сможет ли каждый восстановить идею по памяти и применить её в новой задаче. Чтобы это проверить, можно добавить короткое задание, в котором ученик сам покажет ход мысли. Практичес
 Полезные материалы
10
мин
17.10.2026
Как сохранить готовность сотрудников вмешаться, когда решение принимает ИИ
Представим систему, которая месяцами почти без ошибок сортирует заявки или проверяет документы. Сотрудник просматривает её рекомендации, но редко что-то меняет. Потом появляется необычный случай, и решение нужно принять самому. Формально человек всё это время оставался «в контуре». Но сохранил ли он
 Полезные материалы
13
мин
17.10.2026
Pla2g2f и стареющий мозг: почему результат на мышах ещё не стал способом сохранить память у людей
В старом гиппокампе мыши достаточно изменить работу одного гена, чтобы увидеть сразу несколько связанных изменений: дендритных шипиков становится больше, реактивность глии снижается, липидный обмен меняется, а животное лучше справляется с одной из задач на память. Именно такой результат получили в р