


Содержание статьи
Как ИИ-подсказки помогают проектировать белки и почему их всё ещё проверяют в лаборатории
Аспирантура
04.11.2026
04.11.2026
8
мин
Представим условный запрос: «создай белок, который светится зелёным, как GFP». На выходе появляется не пробирка с готовым реагентом, а аминокислотная последовательность. Между этими двумя точками лежит длинная цепочка проверок. Исследование в Nature показывает, как эту цепочку устроила модель Pinal, созданная группой исследователей из Китая.
Pinal принимает описание желаемой функции на естественном языке и выдаёт кандидатов для дальнейшего изучения. Авторы проверили четыре задачи: флуоресцентный белок, гидролазу полиэтилентерефталата, алкогольдегидрогеназу и метаболический H-белок. В каждом классе они сообщили об экспериментально наблюдаемой ожидаемой функции. Но этот результат нельзя читать как обещание, что любой текстовый запрос с высокой вероятностью даст работающий белок.
Что именно делает Pinal
В статье Pinal описана как базовая модель с 16 млрд параметров, обученная на 1,7 млрд синтетически размеченных пар «белок и текст». Речь не о 1,7 млрд готовых рецептов. Исследователи использовали белковые последовательности, функциональные аннотации и предсказанные структуры. Языковая модель превращала функциональные метки в связные описания, а структурные данные получали, в частности, из базы AlphaFold. Так модель училась связывать описание функции, пространственную организацию и порядок аминокислот.
Генерация проходит в два этапа. Модуль T2struct переводит текст в структурный план. Это не готовая трёхмерная модель, а линейная последовательность структурных токенов, которые кодируют пространственные отношения между аминокислотами и их ближайшими соседями. Затем SaProt-T получает исходное описание и структурный план и строит аминокислотную последовательность. По объяснению разработчиков, глобальная переоценка вероятностей на втором этапе помогает не отбросить «немного менее вероятную структуру, которая может вместить гораздо более удачную функциональную последовательность».
Такой подход похож на проектирование здания по двум связанным чертежам. Один задаёт форму и взаимное расположение деталей, другой подбирает конкретные материалы. Но белок сложнее здания: небольшое изменение последовательности может повлиять на сворачивание, устойчивость или активность молекулы. Поэтому структурный план и правдоподобная последовательность ещё не равны работающей функции.
Почему кандидатов остаются десятки
Самая важная часть процесса начинается после генерации. Кандидатов ранжируют и отбрасывают с помощью вычислительных фильтров, а затем проверяют лишь небольшую часть библиотеки.
Для флуоресцентного белка в описании Extended Data Fig. 7 на странице Nature указано, что после многоступенчатой фильтрации для эксперимента выбрали 29 кандидатов. Журналистский разбор Ars Technica сообщает, что флуоресценцию показал один из них. В этой задаче исследователи специально отбрасывали последовательности, похожие на известные флуоресцентные белки, и оставляли варианты с бочкообразной структурой и аминокислотой, необходимой для образования флуоресцентного хромофора. Поэтому результат относится к жёстко отобранному подмножеству и не даёт общей вероятности успеха для всех сгенерированных белков.
Для PET-гидролазы изначально оставили последовательности, прошедшие фильтры по предсказанной структуре и соответствию текстовому описанию. Из них 2 416 вариантов удовлетворяли заданным порогам, а 94 лучших проверили в тесте эстеразной активности. После этого выделили один вариант, который продвинули к проверке гидролиза PET.
В задаче с алкогольдегидрогеназой из 2 500 сгенерированных последовательностей фильтры прошли 1 639. Затем для дальнейшей приоритизации случайно оставили 1 000, из которых выбрали восемь разнообразных кандидатов. Пять ферментов успешно подтвердили экспериментально.
Эти числа описывают не «способность ИИ проектировать белки вообще», а конкретные воронки отбора. Чем строже фильтры и чем меньше финальная группа, тем сильнее итог зависит от того, какие варианты исследователи решили проверять.
Что показал эксперимент
В аннотации Nature авторы сообщают о наблюдаемой ожидаемой функции во всех четырёх классах задач, включая каталитическую активность двух спроектированных ферментов. Для одного варианта H-белка они указали увеличение выхода продукта в 1,7 раза по сравнению с соответствующим природным H-белком Escherichia coli в многокомпонентном пути фиксации CO₂.
Фраза «без итеративной экспериментальной оптимизации» здесь требует аккуратного прочтения. Она означает, что этот вариант не улучшали последовательными циклами мутаций и лабораторного отбора. Она не означает, что исследователи сразу проверили единственную последовательность. В описании Extended Data Fig. 10 говорится о фильтрации примерно тысячи H-белков, выборе 20 высокорейтинговых кандидатов и подтверждении активности пяти вариантов.
Таким образом, практический результат работы выглядит не как «текст напрямую превращается в белок», а как связка из генерации, компьютерного сокращения библиотеки, получения нескольких кандидатов и измерения функции. В этом смысле Pinal снижает необходимость вручную задавать все структурные и последовательностные ограничения, но не устраняет биологическую проверку.
Что можно сделать с открытым кодом
Репозиторий Pinal на GitHub содержит инструкции и пример генерации десяти последовательностей по описанию «Actin». В README также рекомендованы инструменты для вычислительной оценки: ProTrek для проверки соответствия текста и последовательности, а pLDDT и PAE из AlphaFold или ESMFold для оценки предсказанной структурной надёжности.
Показанный пример кода генерирует последовательности, но сам этот фрагмент README не демонстрирует проверку их сворачиваемости или функции. Даже хорошие вычислительные оценки не заменяют получение белка и измерение активности. Чтобы не путать правдоподобную последовательность с подтверждённым результатом, полезно держать в голове тот же принцип, который мы разбирали в статье о том, почему научному ИИ мало находить закономерности и зачем ему проверять гипотезы.
Что остаётся неизвестным
Первичная статья прошла рецензирование и опубликована 21 октября 2026 года. Однако в доступном материале полный текст методов и дополнительные протоколы не приведены целиком. Поэтому по имеющимся данным нельзя надёжно восстановить все условия лабораторных измерений, контрольные сравнения и статистику по четырём задачам.
Есть и ограничение воспроизводимости данных. Авторы пишут, что полный обучающий корпус не будет опубликован. В переводе их формулировка звучит так: «Поскольку полностью эти материалы публично опубликованы не будут, авторы вместо этого открывают код вывода и оценки, инструкции по использованию модели, обученные веса и веб-сервер». Они связывают это с рисками двойного применения. В статье также сказано, что структурная часть корпуса получена из AlphaFold Protein Structure Database, где нет вирусных протеомов, и что Pinal не обучалась и не предназначалась для дизайна вирусных белков.
Открытые веса и код позволяют изучать интерфейс и вычислительную часть системы. Но независимая оценка обучающего корпуса ограничена, а успешные лабораторные примеры относятся к отобранным кандидатам. Поэтому работа убедительно показывает возможность использовать естественный язык как интерфейс генерации белковых кандидатов, но не доказывает, что модель стала универсальным конструктором ферментов.
Граница между текстовым запросом и биологической функцией проходит не в момент появления аминокислотной последовательности. Она проходит после фильтрации, синтеза и измерения активности. Компьютер предлагает кандидатов, а лаборатория проверяет, стал ли среди них белок.
Источники
Dai, F., You, S., Zhu, Y. et al. Programmable design of functional proteins from natural language. Nature, 2026. DOI: 10.1038/s41586-026-11205-z. Рецензируемая первичная работа; полный текст доступен по подписке, на странице Nature доступны аннотация, сведения о рецензировании, описания рисунков, исходные данные и дополнительные материалы.
Timmer, J. Vibe genes? Natural(ish) language comes to protein, genome design software. Ars Technica, 27 октября 2026 года. Полный текст журналистского разбора. Вторичный источник, использованный для пояснения устройства двухэтапной генерации и результата для GFP.
Westlake University RePL. Denovo-Pinal: Programmable Design of Functional Proteins from Natural Language. GitHub. Официальный репозиторий проекта.
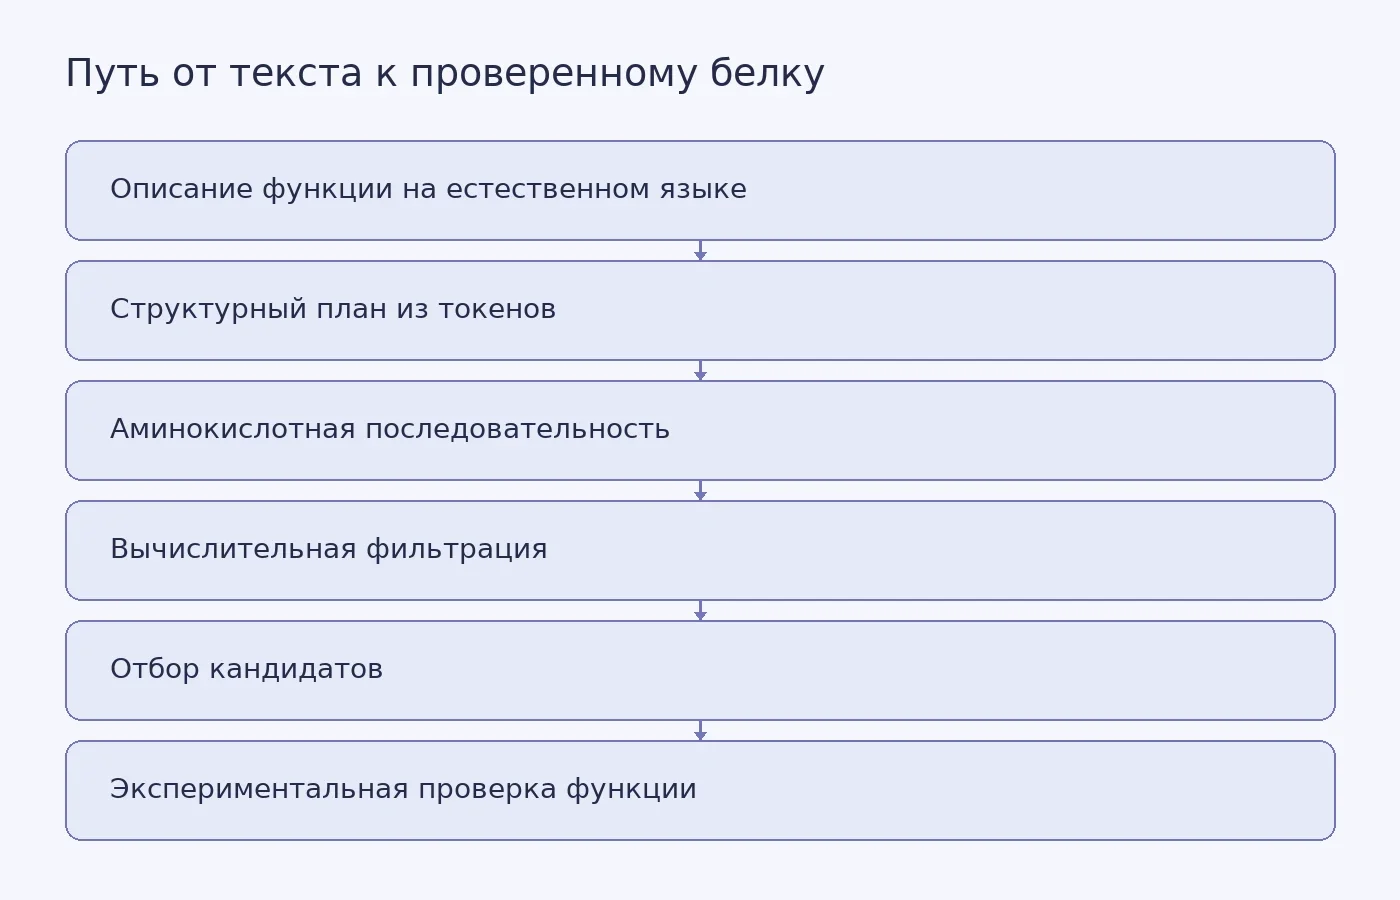
Фото: doctor-a / Pixabay


Похожие статьи
 Аспирантура
9
мин
15.10.2026
Структура кандидатской диссертации: пример содержания и логика глав
Оглавление диссертации похоже на маршрут исследования. Сначала автор объясняет, что уже известно о проблеме, затем описывает методы и материалы, а в конце показывает, к каким выводам пришёл. Порядок глав зависит от темы: работа с историческими источниками, эконометрическая модель и технический экспе
 Аспирантура
8
мин
27.10.2026
Как разобрать даты 03/04/2026 и не перепутать день с месяцем
Строка 03/04/2026 может означать и 3 апреля, и 4 марта. Даже если программа успешно её разобрала, это ещё не доказывает, что выбран верный смысл. Сначала нужно установить порядок полей по документации источника, а затем проверить, существует ли такая календарная дата. Исходную строку при этом сохран
 Аспирантура
8
мин
31.10.2026
Тихая пауза после учёбы: что отдых делает с памятью и почему не заменяет сон
После занятий можно сразу открыть ленту, включить игру или несколько минут посидеть в тишине. Для памяти это разные паузы. В экспериментах недавно выученное иногда лучше сохранялось, если после обучения человек отдыхал без новых задач. Но сходство некоторых результатов отдыха и короткого сна не озна
 Аспирантура
10
мин
01.11.2026
Когда ИИ пишет за нас: что происходит с самопониманием и отношениями
Вам пишут что-то неожиданное, а подходящего ответа нет. Можно открыть языковую модель, вставить переписку и через несколько секунд получить вежливое, точное, почти безупречное сообщение. Но за это удобство иногда платят не только приватностью или искренностью. Пока модель подбирает слова, человек мо
 Аспирантура
7
мин
26.07.2023
10490
Мотивационное письмо в аспирантуру
Мотивационное письмо для поступления в аспирантуру – это эссе, которое поможет составить первое впечатление об абитуриенте, ознакомиться с его достижениями, знаниями и навыками по желаемой образовательной программе. Чтобы выгодно выделиться из толпы желающих поступить в аспирантуру, следует гр
 Аспирантура
13
мин
24.07.2023
10121
Все об аспирантуре
Аспирантура – это одна из форм послевузовского образования. В аспирантуру разрешается поступить после окончания магистратуры или специалитета. Чтобы учеба в аспирантуре принесла пользу, нужно обладать предрасположенностью к проведению исследовательской, аналитической или творческой деятельност
Последние новости и статьи
 Дипломы
9
мин
04.11.2026
Как отличить клонированный голос от живого: что показывают джиттер, шиммер и водяные знаки
В январе 2024 года десятки тысяч избирателей в Нью-Гэмпшире получили робозвонок якобы от Джо Байдена с призывом не голосовать на праймериз. Голос синтезировал сервис ElevenLabs, где мгновенное клонирование стоит от 5 долларов в месяц. Осенью 2026 года Scientific American напомнил о деле, где человек
 Дипломы
11
мин
04.11.2026
Почему аспиранты в Индонезии боятся жаловаться на научных руководителей
Во время научной стажировки в Западном Мичиганском университете математик Рулли Чаритас Прамана, преподаватель Университета Ахмада Дахлана в индонезийской Джокьякарте, увидел, как его американский коллега в выходной день катается на велосипеде вместе со своими аспирантами. Для него это оказалось кул
 Оформление и требования к диссертации
10
мин
04.11.2026
Белый трюфель в жару: что могут дать лес и полив
Первого октября 2026 года в лесах вокруг Альбы, где добывают самый известный белый трюфель, охотники-«трифолау» открыли сезон. Месяц спустя Associated Press подвёл предварительные итоги: летняя жара отозвалась и размером грибов, и ценой. Антонио Деджакоми, президент Национального центра изучения трю
 Наука
4
мин
03.11.2026
Кровь задолго до симптомов: что показал тест на ptau-217 у почти 3 000 пожилых людей
У людей без жалоб на память очень высокий уровень белка ptau-217 в крови связан с резко повышенным риском болезни Альцгеймера в следующие десять лет. К такому выводу пришла группа исследователей из Mass General Brigham во главе с нейробиологом Рэйчел Бакли: они проанализировали данные почти 3 000 по
 Наука
3
мин
03.11.2026
Плотная сейсмическая сеть выявила два магматических резервуара под Килауэа
Группа исследователей под руководством Lin et al. получила сейсмическое изображение магматической системы под вершиной Килауэа и различила два отдельных резервуара: один под кратером Халемаумау в главной кальдере, другой под южной кальдерой. Об этом сообщает Eos со ссылкой на статью в Journal of Geo
 Образование
5
мин
03.11.2026
Педагоги детского сада КФУ собрали заказ в «Тихом кафе» из карточек PECS
В специальном (коррекционном) детском саду для детей с расстройствами аутистического спектра Казанского федерального университета «Мы вместе» педагогический коллектив провёл занятие «Тихое кафе. Национальная кухня Татарстана». Пресс-служба КФУ сообщила о нём 3 ноября 2026 года. Меню было визуальным: