


Содержание статьи
Вопросы студентов
25.10.2026
25.10.2026
7
мин
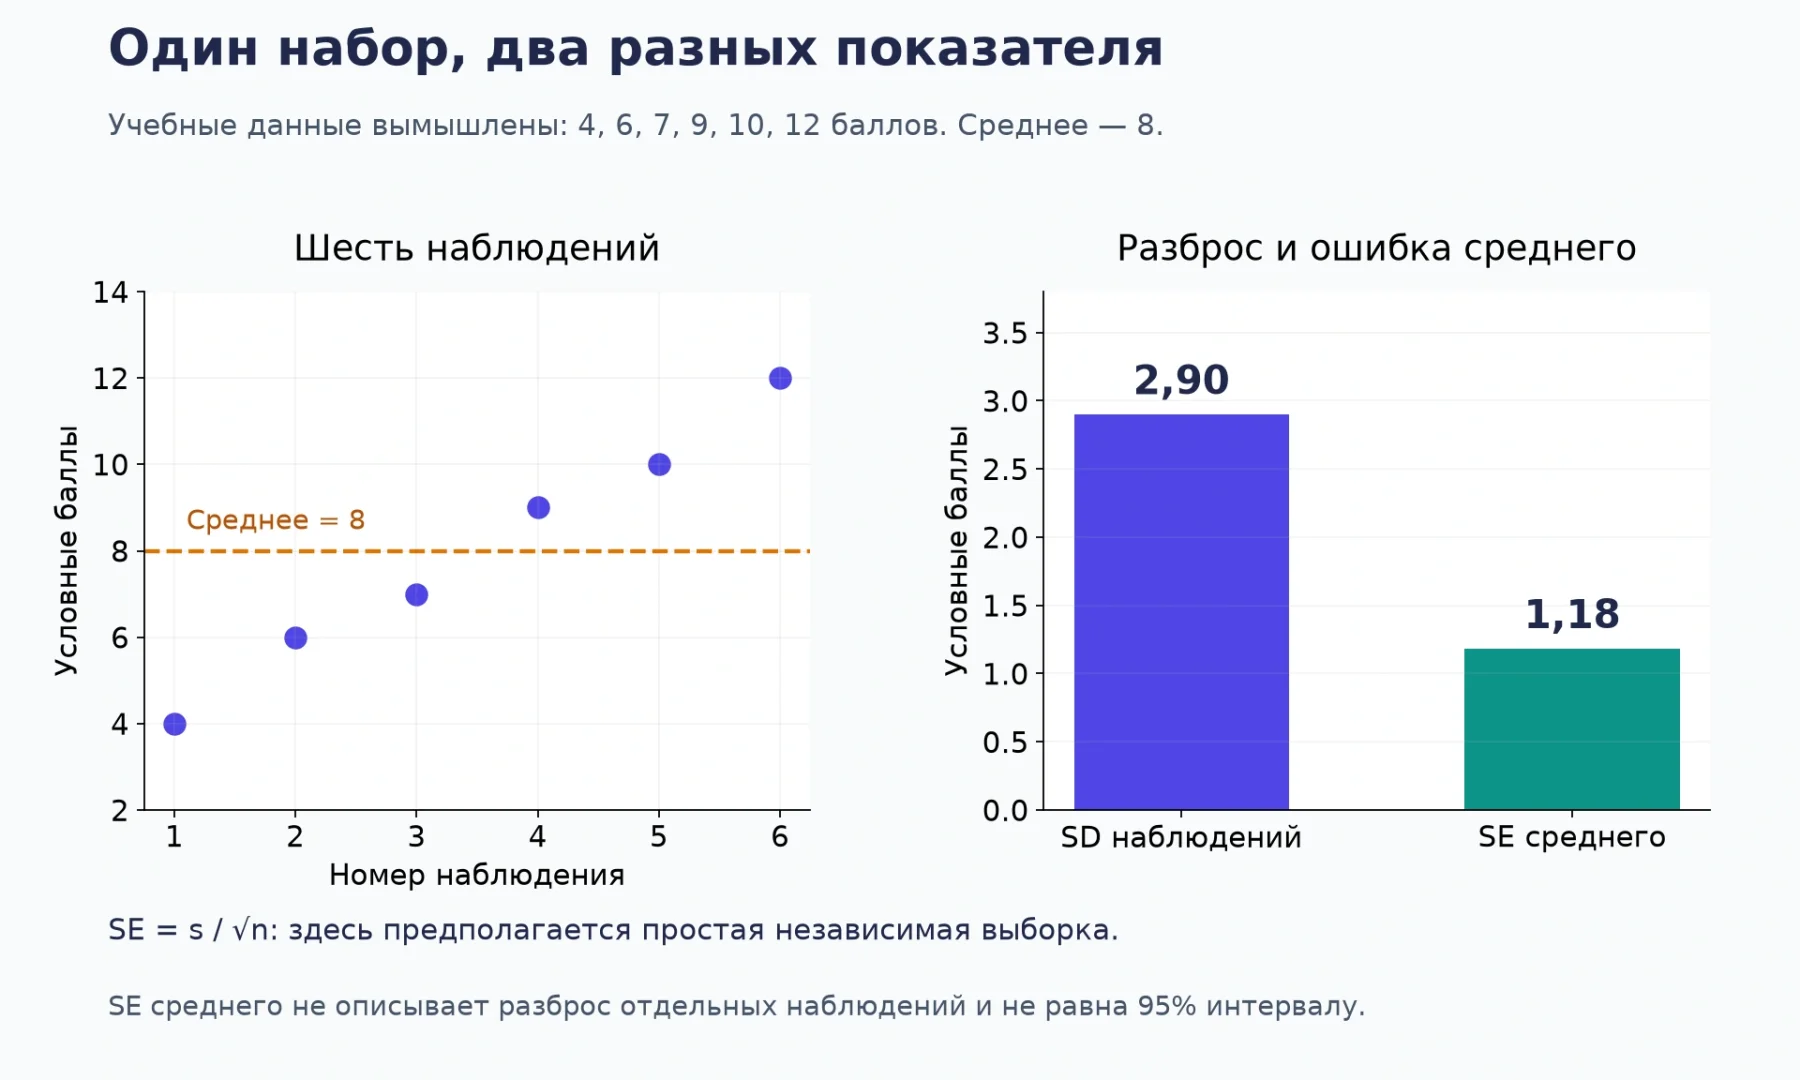
Представьте, что у вас есть шесть чисел — 4, 6, 7, 9, 10 и 12 условных баллов. Их среднее арифметическое равно 8. Но одного среднего недостаточно, чтобы описать данные. Насколько отдельные значения разбросаны вокруг восьмёрки? И насколько точно это среднее оценивает истинное среднее значение в популяции, из которой взята выборка? Тут и появляются два похожих, но разных показателя — стандартное отклонение (SD) и стандартная ошибка среднего (SE).
Что описывает SD, а что — SE?
Стандартное отклонение (SD) показывает разброс отдельных наблюдений в исходных данных. Если SD маленькое, значения плотно прилегают к среднему; если большое — разбросаны широко.
Стандартная ошибка среднего (SE) — стандартное отклонение распределения выборочных средних. Она описывает вариабельность оценки среднего при повторном получении выборок по одной модели, а не размах отдельных наблюдений и не фактическую ошибку именно этой выборки.
Разницу удобно видеть в таблице.
| Вопрос | Что описывает SD | Что описывает SE | Обозначение и единицы |
|---|---|---|---|
| Как разбросаны сами данные? | Вариация отдельных значений в выборке | — | SD (или s), в тех же единицах, что и данные |
| Насколько точно оценивается среднее популяции? | — | Неопределённость выборочного среднего | SE (или SEM), в тех же единицах, что и данные |
Пошаговый расчёт на шести числах
| x | x−8 | Квадрат отклонения |
|---|---|---|
| 4 | -4 | 16 |
| 6 | -2 | 4 |
| 7 | -1 | 1 |
| 9 | 1 | 1 |
| 10 | 2 | 4 |
| 12 | 4 | 16 |
| Сумма 48 | Сумма 0 | Сумма 42 |
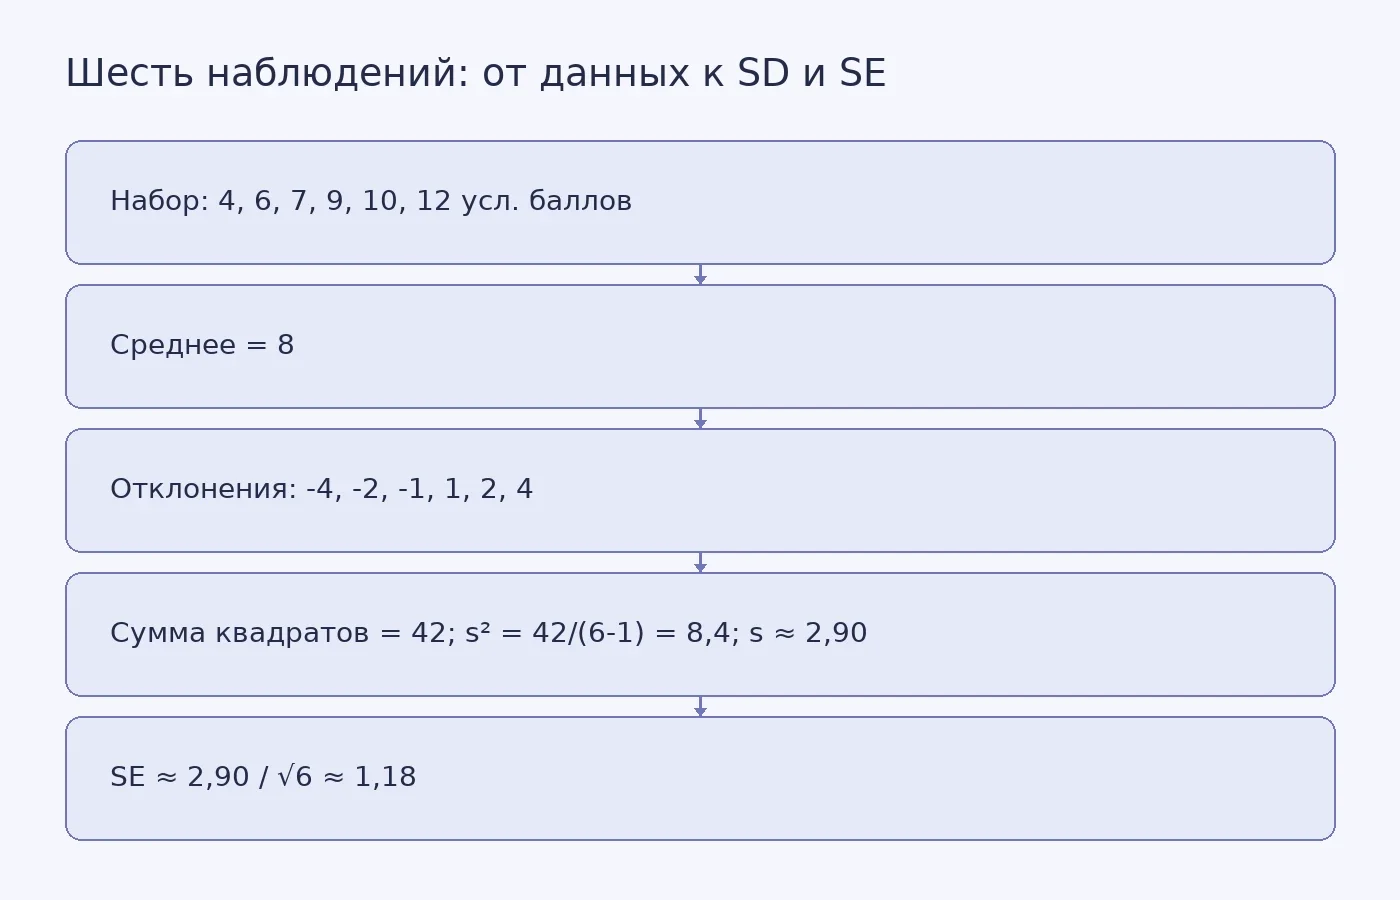
Возьмите наши вымышленные значения: 4, 6, 7, 9, 10, 12. Это не результат реального исследования, а просто учебный пример.
- Среднее: (4 + 6 + 7 + 9 + 10 + 12) / 6 = 48 / 6 = 8.
- Отклонения от среднего (x − 8): −4, −2, −1, 1, 2, 4.
- Квадраты отклонений: 16, 4, 1, 1, 4, 16. Сумма квадратов = 42.
- Выборочная дисперсия (s²): 42 / (6 − 1) = 42 / 5 = 8,4. Деление на n − 1, а не на n, поправка на то, что мы оцениваем дисперсию неизвестной популяции по выборке (OpenStax, формула выборочной дисперсии).
- Стандартное отклонение (s): √8,4 ≈ 2,8983. Разброс отдельных наблюдений — почти 3 балла.
Теперь для простой независимой одинаково распределённой выборки применяем формулу оценки стандартной ошибки среднего: SE ≈ s / √n. Здесь n = 6.
SE = 2,8983 / √6 ≈ 1,1832. Это оценка того, насколько среднее 8 может отклоняться от истинного среднего популяции (если бы мы знали его).
Важно. Если бы эти шесть чисел составляли всю конечную популяцию, описательное популяционное SD рассчитывалось бы иначе: √(42 / 6) ≈ 2,6458. В учебных работах всегда уточняйте, что именно вы вычисляете — характеристику выборки или всей совокупности.
Как не перепутать SD и SE в отчёте
Одна из возможных ошибок — записать «среднее ± SD», а на самом деле подставить SE, или наоборот. Запись 8 ± 2,90 без пояснения неоднозначна. Явно указывайте, что стоит после знака ±.
Правильно:
- «Среднее арифметическое составило 8,00 баллов (SD = 2,90; n = 6)» — если описываете разброс данных.
- «Среднее арифметическое составило 8,00 баллов (SE = 1,18; n = 6)» — если показываете точность оценки среднего.
SD и SE сами по себе не являются 95% доверительным интервалом. Например, для независимой выборки из нормальной популяции при неизвестной дисперсии классический двусторонний 95% t-интервал среднего имеет вид: среднее ± t(0,975; n−1) × s / √n. Здесь t(0,975; n−1) — квантиль t-распределения с n−1 степенями свободы. Условия и формулу приводит справочник NIST. Это не универсальная формула для любого дизайна. Запись «95% наблюдений лежат в среднем ± SE» не следует из определения SE.
Чтобы лучше понять, как выглядят разные шкалы и как интерпретировать числа в таблицах, советуем прочитать статью о шкалах измерения — номинальной, порядковой, интервальной и отношений.
Условный пример изменения n
Для отдельного арифметического сценария предположим неизменное SD=2,8983. Тогда приn=24 оценкаSE=2,8983/√24≈0,5916, а приn=96 —2,8983/√96≈0,2958. Это условное сравнение формулы, а не новые измерения или выполненная симуляция.
Когда простая формула SE не работает
Формула оценки SE=s/√n предполагает подходящую модель независимых одинаково распределённых наблюдений. При кластерах, повторных измерениях у одного человека или другом сложном дизайне её нельзя применять автоматически: способ оценки ошибки должен учитывать структуру данных.
Отдельно проверьте, кого представляет выборка и на какую группу вы хотите переносить выводы. Этому посвящён материал о репрезентативной выборке.
Чек-лист перед оформлением результата
- Вы чётко определили, что именно вычисляете — SD или SE?
- Рядом с числом указан сам показатель (словом или принятым символом)?
- Если вы пишете «среднее ± …», явно названо, что следует за знаком?
- Вы не перепутали выборочное SD с популяционным (проверьте знаменатель)?
- Вы не выдаёте SE за доверительный интервал или 95 % диапазон данных?
- Дизайн вашего исследования действительно позволяет применять простую формулу SE = s / √n?
- Если данные представляют всю конечную совокупность, вы указали это и использовали N в знаменателе?
Эти вопросы помогут избежать путаницы между разбросом данных и точностью оценки среднего. Если вам нужна помощь с расчётами или интерпретацией статистики в научной работе, обратитесь к услуге статистического анализа.


Похожие статьи
 Вопросы студентов
8
мин
24.10.2026
Нейросети для поиска научных статей: сравнение Elicit, Consensus и Semantic Scholar
Допустим, для курсовой нужно понять, помогают ли короткие перерывы в учёбе запоминать материал. Один запрос в поисковике выдаёт статьи, обзоры и страницы, похожие по словам, но не всегда отвечающие на вопрос. Нейросетевые сервисы могут искать публикации по смыслу и кратко пересказывать их. Однако дл
 Вопросы студентов
7
мин
25.10.2026
Статистическая и практическая значимость: как читать эффект и доверительный интервал
В разделе «Результаты» написано: «Разница между группами статистически значима, p = 0,03». Но насколько различаются группы? Достаточно ли этой разницы, чтобы изменить практику? Одного p-значения для ответа не хватит. Американская статистическая ассоциация в заявлении 2016 года подчёркивает: p-значен
 Вопросы студентов
9
мин
03.10.2026
Изменения ЕГЭ-2027: что уже опубликовано ФИПИ и чем это отличается от 2026 года
К началу октября 2026 года на сайте ФИПИ лежат два набора документов, и их легко перепутать. Один описывает экзамен, который уже прошёл общественное обсуждение и утверждён, — это КИМ ЕГЭ 2026 года. Второй только предложен к обсуждению: это проекты документов, определяющих структуру и содержание КИМ
 Вопросы студентов
11
мин
24.10.2026
Приложения для записи лекций: сравнение диктофонов и конспектов
В шумной аудитории студенту приходится выбирать: включить диктофон и переслушать лекцию позже или вести конспект по ходу занятия, отмечая формулы, термины и вопросы. Приложение сохраняет речь, а не заменяет записи от руки: в них можно сразу выделить важное и отметить непонятное.Ниже сравниваются Goo
 Вопросы студентов
6
мин
14.10.2026
Как сравнить два отчёта Антиплагиата: чек-лист расхождений для студента
Один файл, два отчёта, разные результаты. Прежде чем искать причину в тексте, проверьте, сравниваете ли вы одну и ту же версию документа и одинаковые ли параметры использовали при проверке. Сам по себе процент не объясняет, почему отчёты разошлись. В руководствах «Антиплагиата» описаны разные модули
 Вопросы студентов
15
мин
06.03.2023
10746
Как проверить цитируемость научной статьи?
Индекс цитируемости – это международный показатель «востребованности» работ определенного ученого, отображающийся в суммарном количестве ссылок на труды, опубликованные в реферируемых изданиях российских/международных баз данных (Российский индекс научного цитирования, Web of Sci
Последние новости и статьи
 Наука
4
мин
25.10.2026
60 участков ДНК, связанных с жиром в печени: что показало МРТ-исследование и почему это пока не тест для всех
Содержание триглицеридов в печени — признак, который наследуется примерно на четверть. По крайней мере, если говорить о той части изменчивости, которую можно объяснить распространёнными однонуклеотидными вариантами. Это показало самое масштабное на сегодня исследование, где почти 72 тысячам участник
 Наука
3
мин
25.10.2026
Кальмар переписывает белки на ходу: новое исследование показывает масштаб редактирования РНК
Кальмар Doryteuthis pealeii правит матричную РНК прямо по ходу работы, не дожидаясь мутаций в ДНК. Команда исследователей из Калифорнийского университета в Сан-Франциско, первый автор которой — молекулярный биолог Джек Моэн, изучила почти 8 000 участков, где такое редактирование меняет белки длинноп
 Наука
2
мин
25.10.2026
Учёные предложили искать «зеркальную жизнь» по свечению молекул
Исследователи Университета Стратклайда и Даремского университета предложили способ искать гипотетическую «зеркальную жизнь» по свечению молекул. Их статья вышла 21 октября 2026 года в журнале Royal Society Open Science. Авторы предлагают измерять флуоресценцию при циркулярно поляризованном свете, од
Вопросы студентов
7
мин
25.10.2026
Статистическая и практическая значимость: как читать эффект и доверительный интервал
В разделе «Результаты» написано: «Разница между группами статистически значима, p = 0,03». Но насколько различаются группы? Достаточно ли этой разницы, чтобы изменить практику? Одного p-значения для ответа не хватит. Американская статистическая ассоциация в заявлении 2016 года подчёркивает: p-значен
 Вопросы студентов
8
мин
25.10.2026
Поисковая стратегия обзора литературы: понятия, запрос и журнал поиска
Рассмотрим учебный вопрос: как студенты используют записи лекций для самостоятельной подготовки? Поиск по нескольким общим словам бывает трудно воспроизвести и проверить. Поэтому сначала сформулируем понятия, составим запрос для конкретной базы и запишем условия его выполнения.Проблема не в поискови
 Вопросы студентов
7
мин
25.10.2026
Таблица сопряжённости: как считать проценты по строкам и столбцам
В одной ячейке таблицы сопряжённости стоит число 3, а рядом с ним могут быть три разных процента: 75%, 60% и 30%. Все они рассчитаны правильно. Меняется знаменатель, поэтому меняется и вопрос, на который отвечает процент. Разберём полностью вымышленный учебный пример. Есть 10 участников из двух груп