


Содержание статьи
Научные статьи
27.10.2026
27.10.2026
7
мин
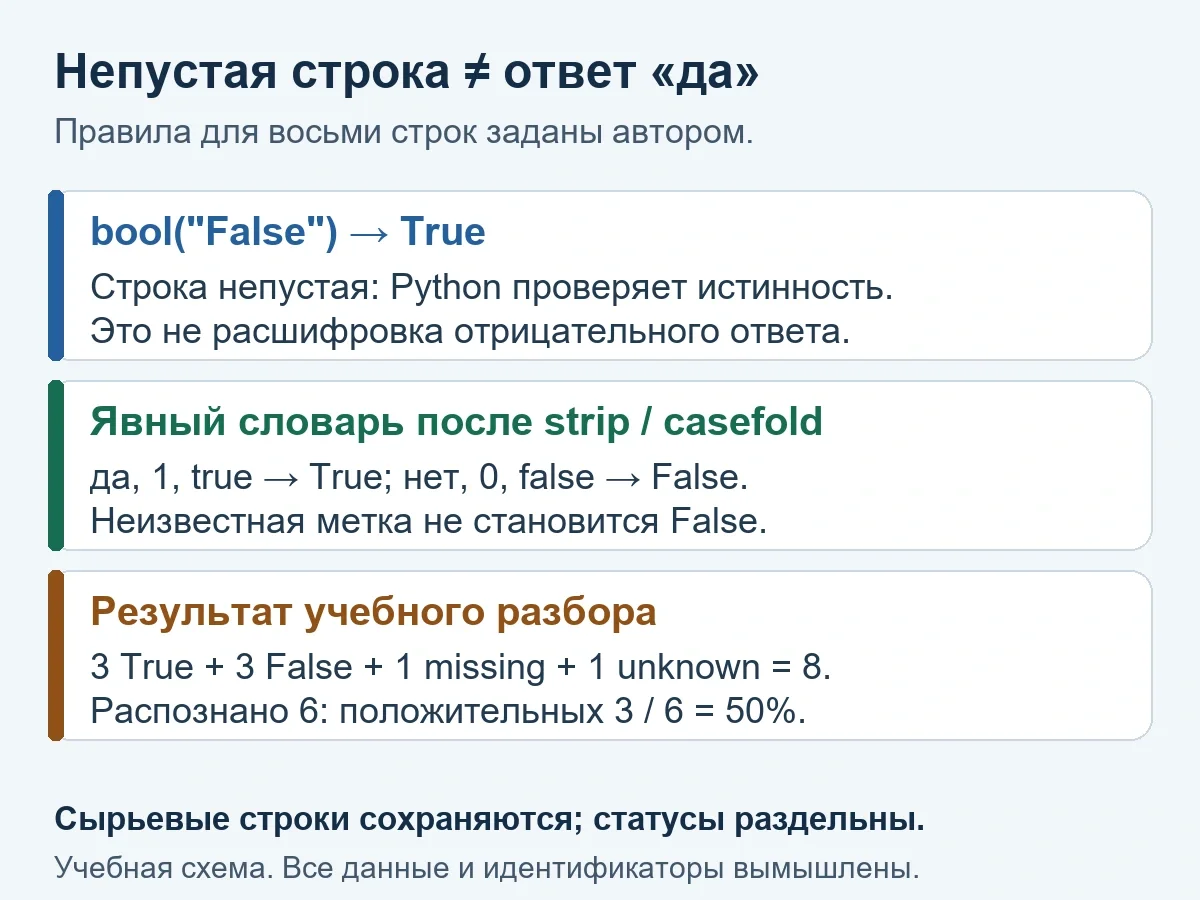
Вы загружаете файл и видите в столбце с опросами слова «Да», «нет», «1», «0», «False». Вы хотите превратить это в логический тип, чтобы посчитать доли или отфильтровать анкеты. Пишете bool("False") — интерпретатор возвращает True. Python не читает написанное слово, он проверяет истинность самого объекта-строки. Любая непустая строка для него истинна, и короткого встроенного преобразователя тут недостаточно. Нужно построить собственный словарь-расшифровщик.
Весь этот пример построен на восьми вымышленных записях с идентификаторами от B01 до B08. По условиям задачи мы приняли простое соглашение: «да», «1», «true» считаются положительной отметкой; «нет», «0», «false» — отрицательной. Регистр не имеет значения, пробелы по краям допустимы и будут аккуратно убраны перед сравнением. Это правило написано для данного конкретного набора данных; оно не обязано совпадать с кодировочной книгой вашего исследования. Все входные значения здесь — строки, так что код и не обещает разбирать сложные объекты.
Что делает bool со строкой
В официальной документации Python 3.12 пустая строка относится к ложным значениям. Непустая строка истинна, независимо от написанных в ней букв. Поэтому bool("0"), bool("False") и bool("нет") дают True, а bool("") даёт False. Число 0 и строка "0" — разные объекты. Для этой задачи истинность контейнера не заменяет расшифровку его содержания.
Зафиксируйте словарь до преобразования
| Допустимая метка после подготовки | Наше значение |
|---|---|
| да, 1, true | True — положительная отметка |
| нет, 0, false | False — отрицательная отметка |
| Пустая строка | None и status=missing — нет значения |
| Любая другая метка | None и status=unknown — требуется уточнение |
Подготовка метки здесь означает strip() без аргумента для удаления пробельных символов по краям, затем casefold() для сопоставления без различения регистра. Эти методы описаны на той же странице Python. Они не исправляют опечатки и не устанавливают смысл незнакомой метки. Правила нужно записать в кодировочной книге данных; нельзя переносить наш словарь в другой проект без проверки.
Все исходные строки и результаты
| ID | Исходная строка → значение; статус |
|---|---|
| B01 | 'Да' → True; ok |
| B02 | 'нет' → False; ok |
| B03 | '1' → True; ok |
| B04 | '0' → False; ok |
| B05 | 'False' → False; ok |
| B06 | '' → None; missing |
| B07 | 'maybe' → None; unknown |
| B08 | ' true ' → True; ok |
Прогоним каждую строчку. Статус ok означает, что метка распознана по нашему словарю. B08 содержит пробелы по краям, но после очистки даёт «true», а значит, получает значение True. B06 — пустая строка, для неё у нас статус missing. B07 пришла как «maybe», такого слова в соглашении нет, поэтому статус — unknown. В обоих последних случаях итоговое значение ставится как None, но причины разные, и в отдельном поле status это чётко прописано. Не нужно приравнивать незнакомую метку к False лишь потому, что её нет в перечне положительных — отсутствие «да» и явное «нет» требуют разной интерпретации.
Полный код для этих восьми строк
raw = ["Да", "нет", "1", "0", "False", "", "maybe", " true "]
mapping = {"да": True, "1": True, "true": True,
           "нет": False, "0": False, "false": False}

def parse_flag(text):
    key = text.strip().casefold()
    if key == "":
        return None, "missing"
    if key not in mapping:
        return None, "unknown"
    return mapping[key], "ok"

for number, text in enumerate(raw, 1):
    value, status = parse_flag(text)
    print(f"B{number:02d}: {value}; {status}")
Вот вывод для данного набора:
B01: True; ok
B02: False; ok
B03: True; ok
B04: False; ok
B05: False; ok
B06: None; missing
B07: None; unknown
B08: True; ok
Сохраните исходные строки в отдельном столбце, например raw. Новое поле value пусть содержит только True, False или None, а соседний столбец status объясняет, почему выбрано именно такое значение. Если источник данных использует варианты вроде «не применимо» или другие служебные коды, обсудите их смысл с автором опросника отдельно, до того как запускать скрипт. Здесь такие ситуации не моделируются. Реальную совместимость с интерфейсом Excel или статистического пакета мы в этом примере не проверяли.
Контроль результата и знаменателя
| Что проверяем | Результат в нашем наборе |
|---|---|
| Положительные отметки | 3: B01, B03, B08 |
| Отрицательные отметки | 3: B02, B04, B05 |
| Нет значения | 1: B06, missing |
| Неизвестная метка | 1: B07, unknown |
| Все исходные строки | 3 + 3 + 1 + 1 = 8 |
| Среди шести распознанных | 3 / 6 = 50% положительных |
| Среди восьми строк | 3 / 8 = 37,5% имеют распознанную положительную отметку. |
Теперь посмотрите на контраст. Если применить bool() напрямую ко всем восьми сырым строкам, вы получите семь True — все непустые строки интерпретируются как истинные. Это проверка факта заполнения ячейки, а не семь согласных респондентов. После применения нашего словаря распознаны шесть ответов: три положительных и три отрицательных. Доля 3/6 = 50% относится к шести осмысленным записям. Доля 3/8 = 37,5% — ко всем строкам в файле. Ни та ни другая цифра не может называться долей реальных людей, ответивших «да», — сам набор вымышлен, и две метки не удалось распознать как содержательный ответ.
Что делать при новой метке
- Сохраните точное исходное написание и идентификатор проблемной строки.
- Оставьте статус unknown отдельно от missing и отдельно от осмысленного False.
- Обратитесь к документации исследования или к автору данных и уточните, что эта метка должна была означать. Не пытайтесь угадать по соседним ответам.
- Если после консультации вы меняете правила, запишите новую версию словарного отображения и заново прогоните все строки, а не только ту, в которой встретилась незнакомая пометка.
- Убедитесь, что каждая строка получила ровно один статус. Общая сумма категорий (ok, missing, unknown) по-прежнему должна равняться восьми — и так при каждой правке правил.
- Функция рассчитана только на строки. Для других типов входных данных сначала проверьте тип и явно задайте отдельный способ обработки.
Если для собственного проекта нужно проверить структуру данных, расчёт и границы вывода, можно обсудить консультацию по статистическому анализу. Заранее согласуйте исследовательский вопрос, состав исходных файлов, правила обработки и объём помощи. Арифметическая проверка сама по себе не подтверждает качество исследования.


Похожие статьи
 Научные статьи
8
мин
07.11.2023
3689
Реферат научных статей
Реферат на научную статью - это краткий обзор-характеристика проделанного исследования. В зависимости от типа реферата, в документе рассматриваются характеристики цели, достигнутые результаты, использованные методы и задачи в решении поставленной научной проблемы. Примерный объем реферата составляет
 Научные статьи
6
мин
04.11.2024
3412
Заключение научной статьи: пример написания
Заключение научной статьи - это заключительная часть исследования, где подводятся итоги проделанного объема работы, выносятся перспективы дальнейшего развития проблемы и авторские рекомендации по внедрению полученных результатов исследования. Рекомендуемая структура заключения научной статьи С
 Научные статьи
6
мин
14.10.2026
Ключевые слова к научной статье: как подобрать и проверить
Представьте, что читатель ищет исследования о том, как городское озеленение влияет на летнюю температуру. Названия вашей статьи он пока не знает. По каким словам ему её найти? Ответ помогает подобрать ключевые слова точнее, чем простое копирование заголовка. Единого для всех журналов числа ключевых
 Научные статьи
5
мин
14.10.2026
Что такое DOI и как проверить его в списке литературы
В списке литературы после названия статьи может стоять короткий код, например 10.1000/182. Если открыть его через doi.org, браузер перейдёт на связанную страницу. Такой код называется DOI, цифровым идентификатором объекта. Что обозначает DOI DOI помогает однозначно обозначить объект и найти связанну
 Научные статьи
7
мин
27.01.2025
3510
Как написать введение научной статьи
Введение научной статьи содержит основную информацию об исследуемой проблеме, обоснование актуальности, краткий литературный обзор ученых-предшественников, характеристику цели и задач работы, а также описание методологии исследования, использованной в работе. Рекомендуемый объем вступительной части
.jpg) Научные статьи
11
мин
07.11.2023
3520
Как правильно оформить научную статью: пример
Грамотное оформление научной статьи упрощает публикацию исследования в выбранном журнале. Соблюдение стандартов к научным публикациям, а также требований и рекомендаций издания являются одними из основополагающих критериев качества публикуемой работы. Требования ГОСТ к оформлению научной статьи
Последние новости и статьи
 Практика
33
мин
27.10.2026
988
Как найти надежные информационные источники для студенческих и научно-исследовательских работ
Надёжный источник выбирают под конкретный исследовательский вопрос. Сначала нужно найти нужный документ, проверить его реквизиты и версию, получить законный доступ к тексту, а затем оценить основания вывода. Ссылка из известной базы помогает найти материал, но не делает любое его утверждение доказан
 Наука
5
мин
27.10.2026
Один укол обманул ВИЧ-подобный вирус на четыре года. Но пока — только у макак
Вирус иммунодефицита обезьян (SIV) вернулся в кровь через неделю после отмены лекарств у всех макак, получавших обычную терапию. В группе, которой добавили один-единственный укол экспериментального антитела, результат оказался иным. Четверо из семи детёнышей оставались без признаков вируса дольше тр
 Оформление работ
6
мин
27.10.2026
Перекрывающиеся интервалы наблюдений: как не задвоить длительность
Представьте журнал, в котором три записи, каждая по часу. В сумме — 180 минут. Но на временной шкале они умещаются всего в два часа. Ошибка возникает, когда сумму длительностей строк выдают за время, в течение которого велось хотя бы одно наблюдение. Это разные показатели, и прежде всего нужно опред
 Магистерские диссертации
7
мин
27.10.2026
Одинаковые на вид ID: как проверить латинскую A и кириллическую А
У вас есть справочник с ключами A01 и A02. На вход подано три строки, и одна из них не присоединяется к справочнику, хотя на экране выглядит такой же. Причина прячется на уровне символов: латинская A и кириллическая А записаны разными кодами. Визуальное сходство не делает строки равными и не доказыв
 Наука
3
мин
27.10.2026
Шумомер вместо судей: 30 октября в ТвГУ пройдёт «Научная битва»
Четверо учёных выйдут к публике в Твери вечером 30 октября 2026 года, но привычных лекций не будет. Каждый получит ровно десять минут, чтобы рассказать о своём исследовании так, как рассказывают захватывающую историю. Победителя назовут не судьи, а шумомер — организаторы из Тверского государственног
 Наука
7
мин
27.10.2026
Чужой страх на своей карте: гиппокамп крысы помечает опасность, увиденную со стороны
Угол тротуара, обледеневший за ночь. Вы видите, как на нём поскальзывается незнакомец, и мозг ставит жирную зарубку: здесь опасно. Сами вы не падали, но карта места обновилась. Группа нейробиологов из Нидерландского института нейронаук под руководством Фредерика Мишона Линде проследила, как именно г