


Содержание статьи
Вопросы студентов
25.10.2026
25.10.2026
9
мин
Представим учебную анкету из шести записей. В двух записях не указано время самостоятельной подготовки, а в двух — ответ о посещении консультации. У одной записи отсутствуют оба ответа. Можно сразу посчитать среднее и проценты, но сначала нужно определить, какие ответы входят в каждый расчёт и от какого числа он считается.
Ниже приведён полностью вымышленный учебный набор. Оба вопроса задали всем участникам, поэтому пустые значения считаются неответами, а не вариантом «неприменимо». В реальной анкете причину отсутствия ответа нужно устанавливать по её структуре и имеющейся документации.
| Запись | Самостоятельная подготовка за неделю, часов | Посещение консультации |
|---|---|---|
| R01 | 2 | Да |
| R02 | 4 | Неответ |
| R03 | Неответ | Да |
| R04 | 0 | Нет |
| R05 | 6 | Нет |
| R06 | Неответ | Неответ |
Ноль в строке R04 — полноценный ответ: участник указал, что не готовился самостоятельно. Если заменить его пропуском, изменится расчёт, а сама запись будет описана неверно.
Считайте пропуски отдельно для каждого показателя
Для каждого показателя считайте пропуски отдельно. Число строк, где заполнены сразу оба показателя, может оказаться меньше числа действительных ответов по каждому из них.
| Что считаем | Заполнено | Пропущено | Записи или значение |
|---|---|---|---|
| Часы подготовки | 4 из 6 | 2 из 6 | R01, R02, R04, R05; сумма значений 12 |
| Посещение консультации | 4 из 6 | 2 из 6 | R01, R03, R04, R05; «Да» — 2 ответа |
| Оба показателя заполнены | 3 из 6 | 3 из 6 не входят в полное подмножество | R01, R04, R05 |
Подсчёт по переменным и числу полных строк помогает описать структуру данных. В кодировочной книге анкеты также фиксируют, что означает каждая переменная, какие ответы считаются допустимыми и кого спрашивали. Это важно, чтобы не смешать пропуск с ответом «нет» или с вопросом, который участнику не задавали.
Выбирайте знаменатель под вопрос
Среднее число часов подготовки среди тех, кто ответил на этот вопрос:
(2 + 4 + 0 + 6) / 4 = 12 / 4 = 3 часа.
В знаменателе стоит четыре: столько действительных значений есть у этого показателя. Ноль из строки R04 входит и в сумму, и в число ответивших.
На вопрос о консультации ответили четверо, двое из них выбрали «Да». Среди ответивших это 2 / 4 = 50%. Если разделить те же две положительные отметки на все шесть записей, получится 2 / 6 ≈ 33,3%. Это доля записей с положительной отметкой среди всех шести, а не доля участников, посетивших консультацию: двое не ответили, и считать их не посетившими нельзя.
Рядом с процентом указывайте его основание: «2 из 4 ответивших» или «2 положительные отметки из 6 записей». Без знаменателя процент может создать неверное впечатление о том, что известно об участниках.
Что меняется при анализе полных строк
Для анализа, которому нужны и часы подготовки, и ответ о консультации, подходят только строки R01, R04 и R05. Среднее число часов в этих строках:
(2 + 0 + 6) / 3 = 8/3 ≈ 2,67 часа.
Здесь изменилось подмножество данных: R02 исключена, потому что в ней нет ответа о консультации, хотя часы подготовки указаны. Среднее 2,67 описывает три полные строки и не становится автоматически оценкой для всех студентов. Отличие от среднего 3 часа само по себе не доказывает смещение в более широкой совокупности. По шести вымышленным записям нельзя установить, с чем связаны пропуски и насколько этот набор отражает других студентов.
Такой способ называют анализом полных случаев: в расчёт входят записи без пропусков по переменным, нужным для конкретного анализа. Из-за этого наблюдений становится меньше, а точность может снизиться. Возможное смещение зависит от причин пропусков, исследовательской задачи и статистической модели. Нельзя считать такой анализ всегда неверным или объявлять его допустимым только при одном универсальном условии.
Почему пропуски появились: предположения, а не ярлыки
Чтобы описать возможные причины пропусков, в статистике используют три предположения о том, как они возникают:
- MCAR, пропуск полностью случаен: вероятность отсутствия ответа не связана ни с наблюдаемыми значениями, ни с теми, которые остались неизвестны.
- MAR, пропуск случаен с учётом наблюдаемых данных: предполагается, что связь с отсутствующим значением объясняется другими известными переменными.
- MNAR, пропуск не случаен даже после учёта наблюдаемых данных: вероятность неответа может зависеть от самого отсутствующего значения.
Это предположения о механизме пропусков, а не категории, которые можно уверенно определить по их проценту. Шести строк недостаточно, чтобы выяснить, какой механизм действует. Даже на большем наборе наблюдаемые данные сами по себе не позволяют надёжно отличить MAR от MNAR. Нужны содержательные основания, а при сложном анализе может понадобиться проверить, меняются ли результаты при разных предположениях.
Не подменяйте пропуск нулём или средним
Если заменить два пропуска в вопросе о часах нулями, записи будут выглядеть так, будто участники ответили «не готовился». Это меняет смысл данных. Если подставить вместо пропусков среднее по имеющимся ответам, то есть 3 часа, среднее останется равным 3, но разброс искусственно уменьшится: оба добавленных значения окажутся ровно в центре наблюдаемых.
Совпадение среднего не делает такую подстановку правильной. Нельзя автоматически выбирать среднее, ноль, исключение строк или более сложную импутацию. Метод зависит от исследовательского вопроса, структуры переменных, объёма данных и обоснованных предположений. Например, множественная импутация требует подходящей модели и ясного описания процедуры. Это не механическое заполнение пустых ячеек.
Как описать неполные данные в работе
Для методического раздела или описания результатов подойдёт такой шаблон. Подставьте свои числа и укажите, как именно обрабатывали пропуски:
В исходном наборе было N = [число] записей. По показателю «[название]» получено [число] действительных ответов и [число] пропусков; по показателю «[название]» — [число] и [число] соответственно. Для анализа [кратко указать, какого] использованы [число] записей, заполненных по всем включённым в него переменным. Пропуски обработаны следующим образом: [описать фактическое решение]. Интерпретацию результатов ограничивает [указать существенное ограничение и, если известна, причину пропусков].
Пример для учебного набора: «В исходном наборе было 6 вымышленных записей. По часам подготовки и посещению консультации получено по 4 действительных ответа и по 2 пропуска. Среднее число часов рассчитано по 4 ответам и составило 3 часа. В анализ, для которого требовались заполненные значения по обоим показателям, вошли 3 записи. Причины неответов в учебном наборе не заданы, поэтому по нему нельзя оценить механизм пропусков или переносить результат на всех студентов».
Если вы сравниваете участников, важно отдельно обосновать, на кого распространяются выводы: для этого полезно разобраться, как описать выборку и её границы. Выборка и пропуски связаны с интерпретацией, но это разные вопросы: полнота ответов сама по себе не доказывает репрезентативность.
Короткий чек-лист
- Проверьте, кому задавали каждый вопрос. Пропуск не равен ответу «неприменимо».
- Посчитайте действительные ответы и пропуски отдельно по каждому показателю.
- Определите, какие переменные нужны для каждого анализа, и посчитайте число подходящих строк.
- Указывайте знаменатель рядом с процентом и называйте подмножество, для которого рассчитан показатель.
- Не заменяйте пустое значение нулём и не подставляйте среднее без обоснованного метода.
- Опишите исходное число записей, правила исключения, число наблюдений в каждом анализе, принятые предположения и ограничения.
- Согласуйте методические решения с научным руководителем и проверьте локальные требования вуза.
Если для вашей задачи нужен выбор статистического метода или проверка расчётов, можно ознакомиться с услугой статистического анализа. Само решение о способе обработки пропусков должно следовать исследовательскому вопросу и быть объяснено в работе.
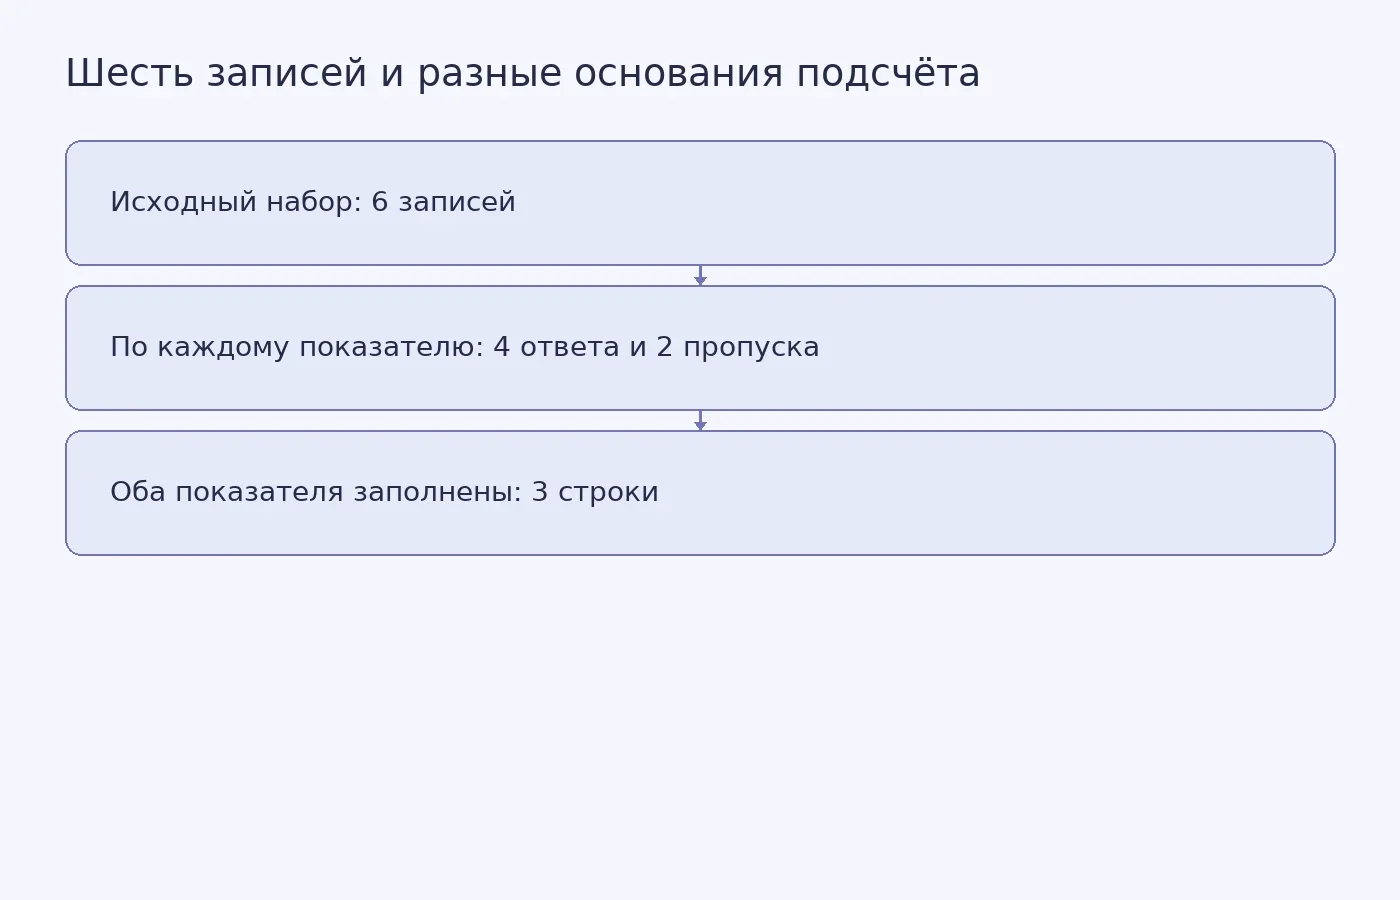
Фото: RDNE Stock project / Pexels


Похожие статьи
 Вопросы студентов
12
мин
25.10.2026
Кодировочная книга анкеты: как описать переменные и проверить данные
Представьте: исследователь открыл таблицу ответов, но не видел анкету. В одной ячейке стоит 97. Это ответ участника, ошибка или пропуск? Кодировочная книга помогает разобраться: она связывает каждую переменную с вопросом, возможными значениями и правилами перехода по анкете. В таблице данных обычно
 Вопросы студентов
11
мин
25.10.2026
Репрезентативная выборка: что это и как обосновать её в исследовании
Представьте: студент хочет выяснить, как учащиеся университета относятся к занятиям в записи. Он публикует анкету в одном студенческом чате и получает много ответов. Но кто увидел приглашение? И так ли охотно отвечали те, кому онлайн-занятия безразличны, как те, кому они нравятся? Количество заполне
 Вопросы студентов
12
мин
25.10.2026
Пилотное исследование: что проверить перед основным этапом
Перед основным опросом студентка замечает, что участники по-разному понимают вопрос: «Как часто вы используете цифровые образовательные ресурсы?». Одни учитывают только платформу вуза, другие добавляют видео и поисковики. Это выяснилось до сбора основных ответов, когда формулировку ещё можно уточнит
 Вопросы студентов
8
мин
25.10.2026
Шкала Лайкерта: пример анкеты, кодирование и разбор ответов
Представьте: студент посмотрел лекцию в записи и отвечает на вопрос: «Насколько удобны учебные видеозаписи?» Если предложить только числа от 1 до 5, без подписей останется неясно, что означает «3» и чем она отличается от «4». Поэтому вопрос и варианты ответа нужно продумывать вместе. На примере учеб
 Вопросы студентов
12
мин
25.10.2026
Операционализация понятий: от темы исследования к показателям
Представим студента, который открывает страницу курса и нажимает на запись лекции. Видео не запускается. В другом случае оно открывается, но нужную тему приходится долго искать. Бывает и так, что запись доступна, однако смотреть её можно только в неудобное время. Во всех трёх ситуациях легко сказать
 Вопросы студентов
7
мин
25.10.2026
Таблица сопряжённости: как считать проценты по строкам и столбцам
В одной ячейке таблицы сопряжённости стоит число 3, а рядом с ним могут быть три разных процента: 75%, 60% и 30%. Все они рассчитаны правильно. Меняется знаменатель, поэтому меняется и вопрос, на который отвечает процент. Разберём полностью вымышленный учебный пример. Есть 10 участников из двух груп
Последние новости и статьи
 Наука
4
мин
25.10.2026
Зубные импланты мешают иммунитету бороться с инфекцией — найден механизм
Примерно каждый десятый — двадцатый пациент с зубными имплантами сталкивается с периимплантитом: воспалением и разрушением кости вокруг импланта. Антибиотики часто не помогают. Исследователи из Rutgers School of Dental Medicine, сообщившие о результатах 23 октября 2026 года, нашли возможную причину
 Наука
3
мин
25.10.2026
Лазерный магнитометр на алмазе дал стопроцентный контраст
Исследователи Института Фраунгофера физики твердого тела IAF поместили алмаз с азотно-вакансионными центрами (NV-центрами) внутрь лазерного резонатора и получили магнитометр, у которого контраст оптического сигнала достиг 100%. Результаты опубликовал 22 октября 2026 года журнал Nature Communications
 Наука
4
мин
25.10.2026
60 участков ДНК, связанных с жиром в печени: что показало МРТ-исследование и почему это пока не тест для всех
Содержание триглицеридов в печени — признак, который наследуется примерно на четверть. По крайней мере, если говорить о той части изменчивости, которую можно объяснить распространёнными однонуклеотидными вариантами. Это показало самое масштабное на сегодня исследование, где почти 72 тысячам участник
 Вопросы студентов
7
мин
25.10.2026
Статистическая и практическая значимость: как читать эффект и доверительный интервал
В разделе «Результаты» написано: «Разница между группами статистически значима, p = 0,03». Но насколько различаются группы? Достаточно ли этой разницы, чтобы изменить практику? Одного p-значения для ответа не хватит. Американская статистическая ассоциация в заявлении 2016 года подчёркивает: p-значен
 Вопросы студентов
7
мин
25.10.2026
Стандартное отклонение и стандартная ошибка: чем различаются SD и SE
Представьте, что у вас есть шесть чисел — 4, 6, 7, 9, 10 и 12 условных баллов. Их среднее арифметическое равно 8. Но одного среднего недостаточно, чтобы описать данные. Насколько отдельные значения разбросаны вокруг восьмёрки? И насколько точно это среднее оценивает истинное среднее значение в попул
 Вопросы студентов
8
мин
25.10.2026
Поисковая стратегия обзора литературы: понятия, запрос и журнал поиска
Рассмотрим учебный вопрос: как студенты используют записи лекций для самостоятельной подготовки? Поиск по нескольким общим словам бывает трудно воспроизвести и проверить. Поэтому сначала сформулируем понятия, составим запрос для конкретной базы и запишем условия его выполнения.Проблема не в поискови